AI 자막
AI 자막은 영상을 보는 동안 영상의 소리(또는 기존 텍스트 자막)로부터 만들어지며, 일반 자막 트랙으로 표시됩니다. 별도 프로세스가 아니라 플레이어에 내장되어 있습니다.
video / disc ─▶ demuxer (reads ahead N seconds) ├─▶ normal playback └─▶ copy of the audio packets ─▶ speech recognition (Whisper, with voice detection) ─▶ translation (your Ollama model) ─▶ subtitle lines with exact timestamps ─▶ shown by the normal subtitle renderer플레이어가 미리 읽기 때문에(기본 120초) 자막은 대사가 재생되기 전에 도착합니다. 파일을 시작할 때 NanumPlayer는 짧은 프리롤(기본 30초) 동안 기다린 뒤 재생합니다.
텍스트는 어디서 오나요
섹션 제목: “텍스트는 어디서 오나요”NanumPlayer는 입력 소스를 자동으로 고르며, Ctrl+N에서 바꿀 수 있습니다.
- 음성 언어를 알고 있고 그 언어의 텍스트 자막(내장 또는
movie.en.srt같은 외부 파일)이 있으면 그 텍스트를 번역합니다. 더 빠르고 정확합니다. - 그렇지 않으면 음성 인식으로 소리를 인식합니다. 강제 자막과 해설 트랙은 건너뜁니다.
- 이미지 자막(PGS)은 이 경로가 아니라 OCR로 처리합니다.
영상에 목표 언어의 자막이 이미 있으면 자동으로 선택되고 그 파일에서는 AI 작업을 하지 않습니다(끌 수 있습니다).
두 개의 트랙: 재생 음성과 원어
섹션 제목: “두 개의 트랙: 재생 음성과 원어”디스크나 파일에 음성 언어가 여러 개 있을 때, 예를 들어 영어 더빙이 있는 일본 영화라면 NanumPlayer는 먼저 재생 중인 음성으로 한국어 (영어 음성 기반)과 같은 자막을 만듭니다. 그다음 낮은 우선순위로 원어 음성에서도 한국어 (일본어 음성 기반)과 같은 트랙을 만듭니다. 원어는 제목과 음성 언어 목록으로 판단합니다. 두 트랙은 디스크를 한 번 읽은 내용에서 만들어지므로 디스크를 추가로 읽을 필요가 없습니다. 자막 목록에서 어느 쪽이든 고를 수 있으며, Ctrl+N에서 끌 수 있습니다.
표시 방식
섹션 제목: “표시 방식”- 번역만(기본값)
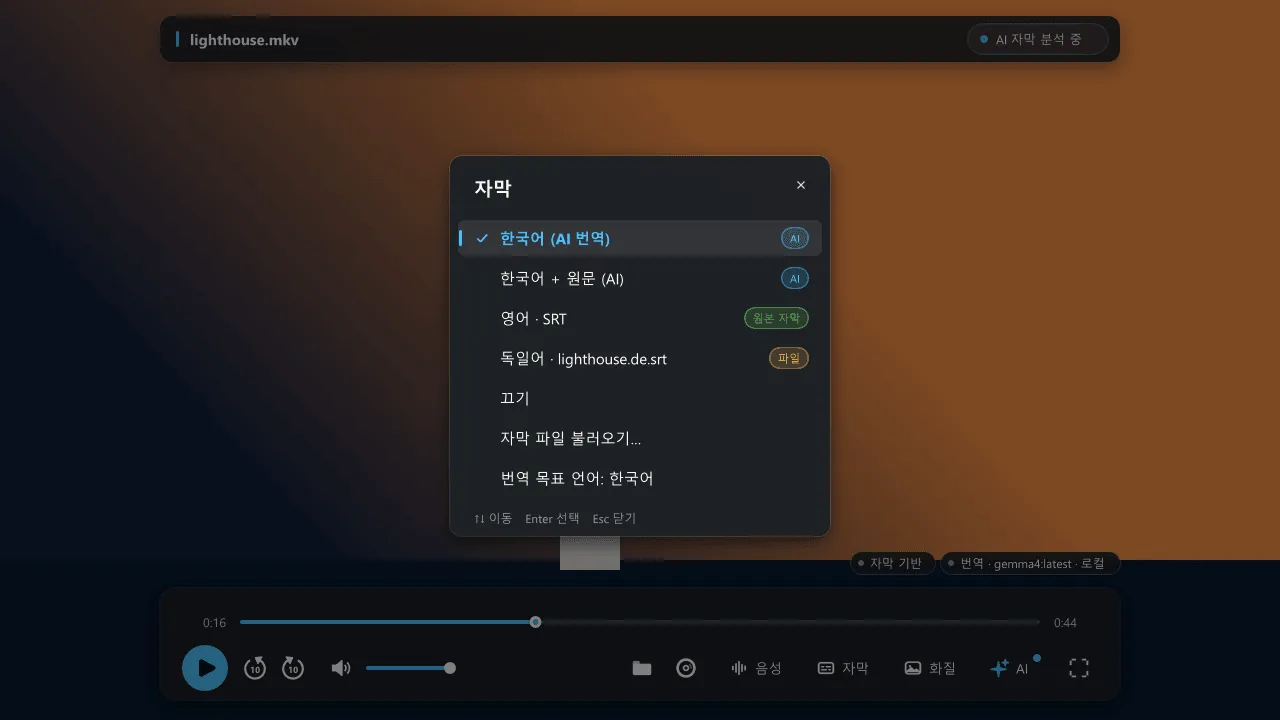
- 번역+원문: 각 줄 아래에 인식된 원문을 함께 보여 줍니다.
- 원문만
표시 방식을 바꿔도 인식이나 번역을 다시 실행하지 않습니다. 번역하지 못한 줄은 화면이 비지 않도록 원어 그대로 표시됩니다.
상태와 탐색
섹션 제목: “상태와 탐색”재생 바 위의 칩은 현재 트랙이 어떻게 만들어지는지(GPU 또는 CPU에서의 음성 인식, 음성 모델, 번역 모델과 실행 위치)를 보여 줍니다. 칩을 누르면 해당 설정이 열립니다. Ctrl+K는 자세한 상태를 보여 줍니다.
위치를 이동하면 새 위치에서 인식을 다시 시작합니다. 타임라인이나 방향키로 이동한 뒤에도 NanumPlayer는 재생을 멈추고 기다리지 않으며, 아직 분석하지 못한 구간의 자막은 조금 늦게 도착할 수 있습니다.
전체 번역 (선택)
섹션 제목: “전체 번역 (선택)”전체 번역을 켜면 별도의 읽기 작업이 전체 대사를 모아 용어집과 함께 문맥을 살려 번역하고, 자동으로 선택되는 완전한 자막 트랙을 만듭니다. 엔진은 기본적으로 같은 Ollama 서버이며, 로그인한 모델을 쓰는 oh-my-pi(omp)도 선택할 수 있습니다. 실시간 번역은 항상 Ollama를 사용합니다.